インデックス作成と OCR
更新日 2026年10月22日
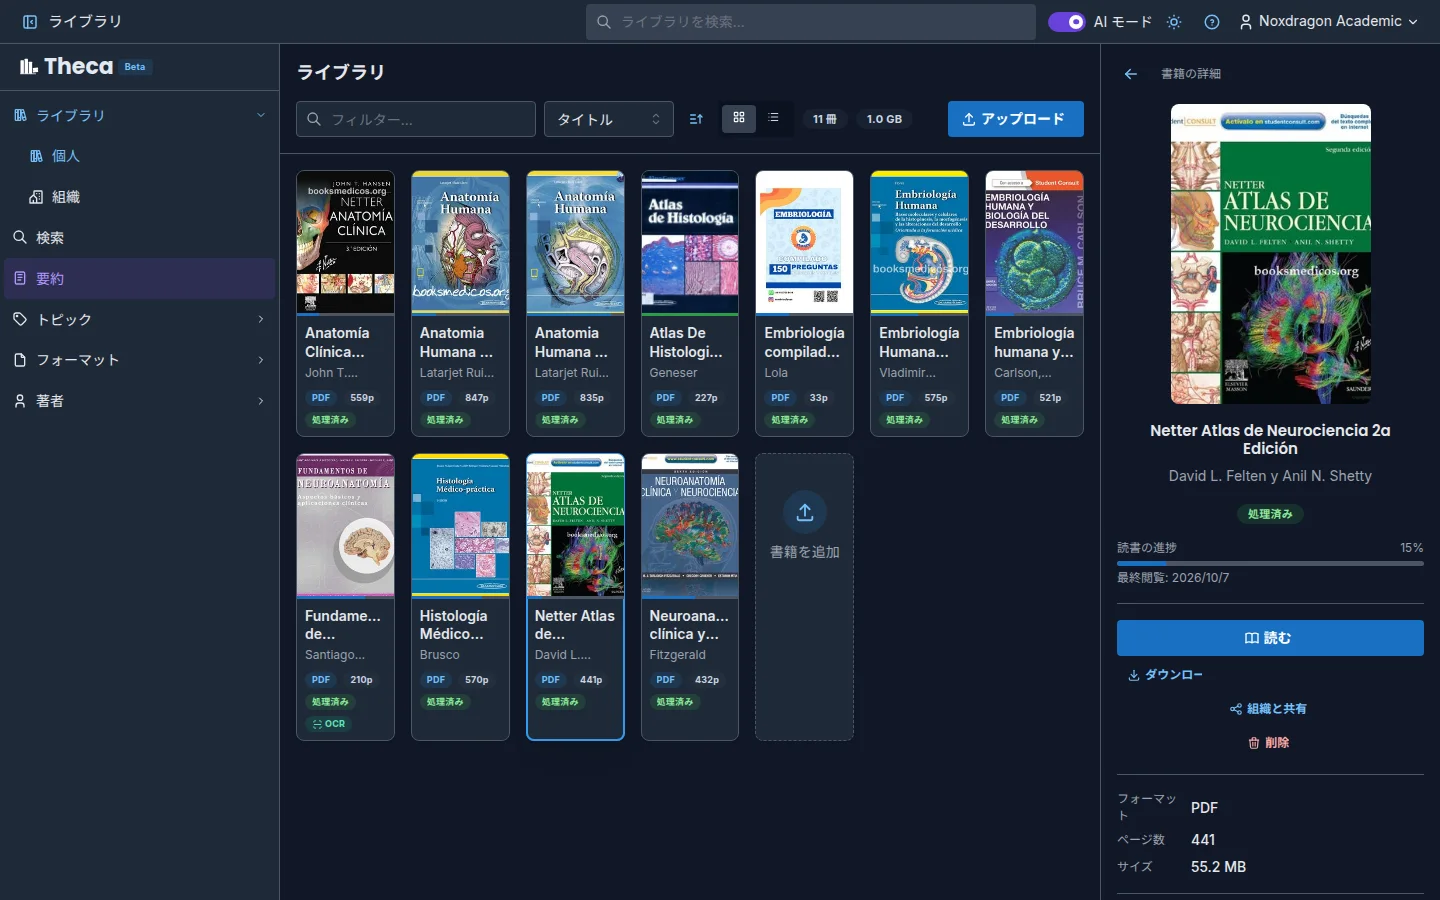
書籍を検索したり要約に使ったりするには、まず Theca がその書籍を処理する必要があります。処理はアップロードのたびに自動で行われます。ここでは、その間に何が起きているかを説明します。
処理で行うこと
Theca は書籍のテキストを抽出して断片に分け、正確な言葉を覚えていなくても意味で文章を見つけられるインデックスを作ります。あわせて PDF の数式や化学表記も検出します。この処理がないと、書籍は読むこととダウンロードしかできません。
スキャンした PDF への自動 OCR
テキスト層がなくページの画像だけでできた PDF(コピーなど)を検出すると、Theca は自動的に光学文字認識(OCR)を実行します。処理中は 抽出中… と進捗がリアルタイムで表示されます(例:抽出中… 40/120)。
完了すると、書籍は他の書籍と同じように検索でき、OCR バッジが付きます。OCR は通常の処理より時間がかかり、特に長い書籍ではその差が大きくなります。
OCR で使えるテキストが見つからなかった場合、ステータスは スキャン、テキストなし になります。それでも書籍は読んだりダウンロードしたりでき、詳細パネルの テキストを抽出(OCR) でもう一度試せます。直前に実行した場合は、再び使えるまでの時間がボタンに表示されます(OCR は … 後)。
各ステータスの意味
- 処理中 — インデックス作成中です。進捗が表示されることがあります(例:
処理中 4/10)。 - 抽出中… — OCR を実行中です。
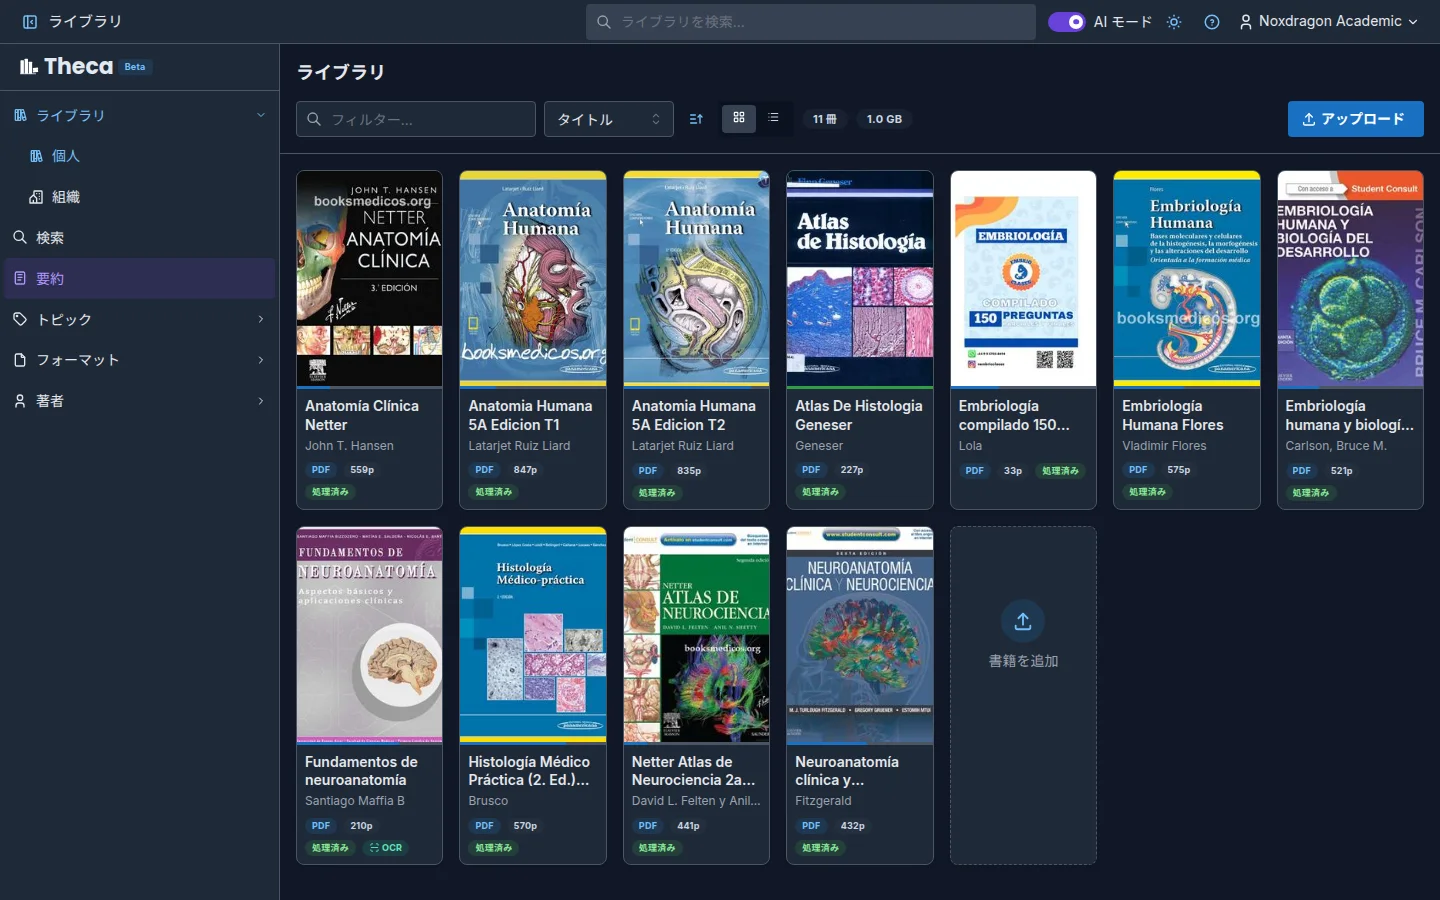
- 処理済み — 検索と要約に使えます。
- 未処理 — まだ処理されていません。パネルの 処理 か、ツールバーの すべて処理 を押してください。
- スキャン、テキストなし — インデックスを作るテキストが見つかりませんでした。
- 停止中 — 処理が長時間進んでおらず、この書籍を処理しているタスクがありません。
- エラー — 再試行 — 問題が発生しました。
まだ検索できない書籍は、サイドバーの 未処理 にまとめて表示されます。
止まった書籍にも必ず対処法があります
書籍が 停止中 や エラー — 再試行 になったら、詳細パネルを開きます。
- 再試行 で、もう一度キューに追加します。
- 停止中の書籍にも テキストを抽出(OCR) が表示されます。原因がスキャンだった場合に使えます。
エラーが繰り返される場合は、ファイルをダウンロードして、お使いの端末で正しく開けるか確認してください。
内容を示すバッジ
- OCR — スキャンからテキストを認識しました。
- 数式 — 認識された数学または化学表記を含んでいます。PDF リーダーの 数式と化学 パネルで、レンダリングされた表記を確認できます。
よくある質問
処理にはどのくらいかかりますか? 一般的なサイズの書籍なら数分です。非常に長い書籍や OCR を行う書籍は、もう少しかかります。
OCR は自分で実行する必要がありますか? いいえ。スキャンした PDF を検出すると、Theca が自動で実行します。テキストを抽出(OCR) ボタンは再試行用です。
処理中の書籍を読めますか? はい、いつでも読めます。
読み取り専用の書籍はどうなりますか? プランのストレージ上限を超えた書籍は、読む、ダウンロード、削除はできますが、再処理はできません。プランと上限 を参照してください。
次のステップ
- ライブラリを検索する — 処理が終わった書籍の検索方法。
- ハイライトと数式 — リーダーの科学表記パネル。
- ライブラリ — ステータスとバッジの一覧。