인덱싱 및 OCR
업데이트: 2026년 10월 22일
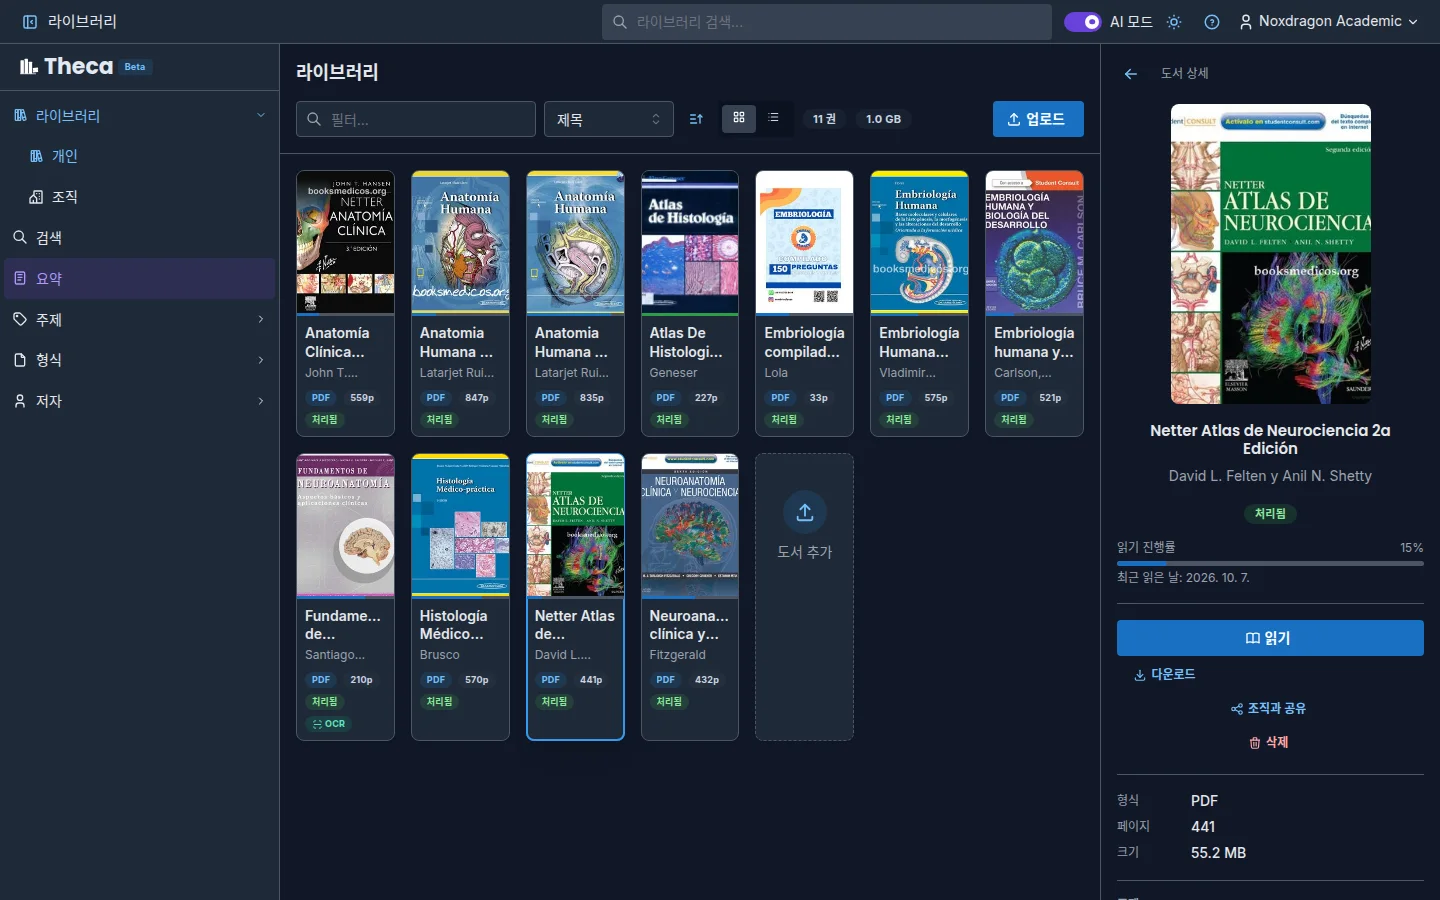
도서를 검색하거나 요약에 사용하려면 먼저 Theca가 도서를 처리해야 합니다. 처리는 업로드할 때마다 자동으로 진행되며, 그동안 일어나는 일을 소개합니다.
처리 과정
Theca는 도서에서 텍스트를 추출하고, 조각으로 나눈 뒤, 정확한 단어가 기억나지 않아도 의미로 구절을 찾을 수 있도록 인덱스를 만듭니다. 이 과정에서 PDF의 수식과 화학 기호도 감지합니다. 처리되지 않은 도서는 읽기와 다운로드만 가능합니다.
스캔 PDF를 위한 자동 OCR
PDF가 텍스트 레이어 없이 페이지 이미지로만 되어 있다면(예: 복사본), Theca가 이를 감지해 광학 문자 인식(OCR)을 자동으로 적용합니다. 작업 중에는 도서에 **추출 중…**과 실시간 진행 상황(예: 추출 중… 40/120)이 표시됩니다.
완료되면 다른 도서처럼 검색할 수 있고 OCR 배지가 붙습니다. OCR은 일반 처리보다 시간이 더 걸리며, 특히 긴 도서에서 그렇습니다.
OCR로 쓸 만한 텍스트를 찾지 못하면 상태가 스캔됨, 텍스트 없음으로 바뀝니다. 그래도 도서를 읽고 다운로드할 수 있으며, 상세 패널의 텍스트 추출 (OCR)로 다시 시도할 수 있습니다. 방금 시도했다면 버튼에 다시 사용할 수 있을 때까지 남은 시간(… 후 OCR)이 표시됩니다.
각 상태의 의미
- 처리 중 — 인덱싱이 진행 중이며, 진행 상황이 표시될 수 있습니다(예:
처리 중 4/10). - 추출 중… — OCR 진행 중.
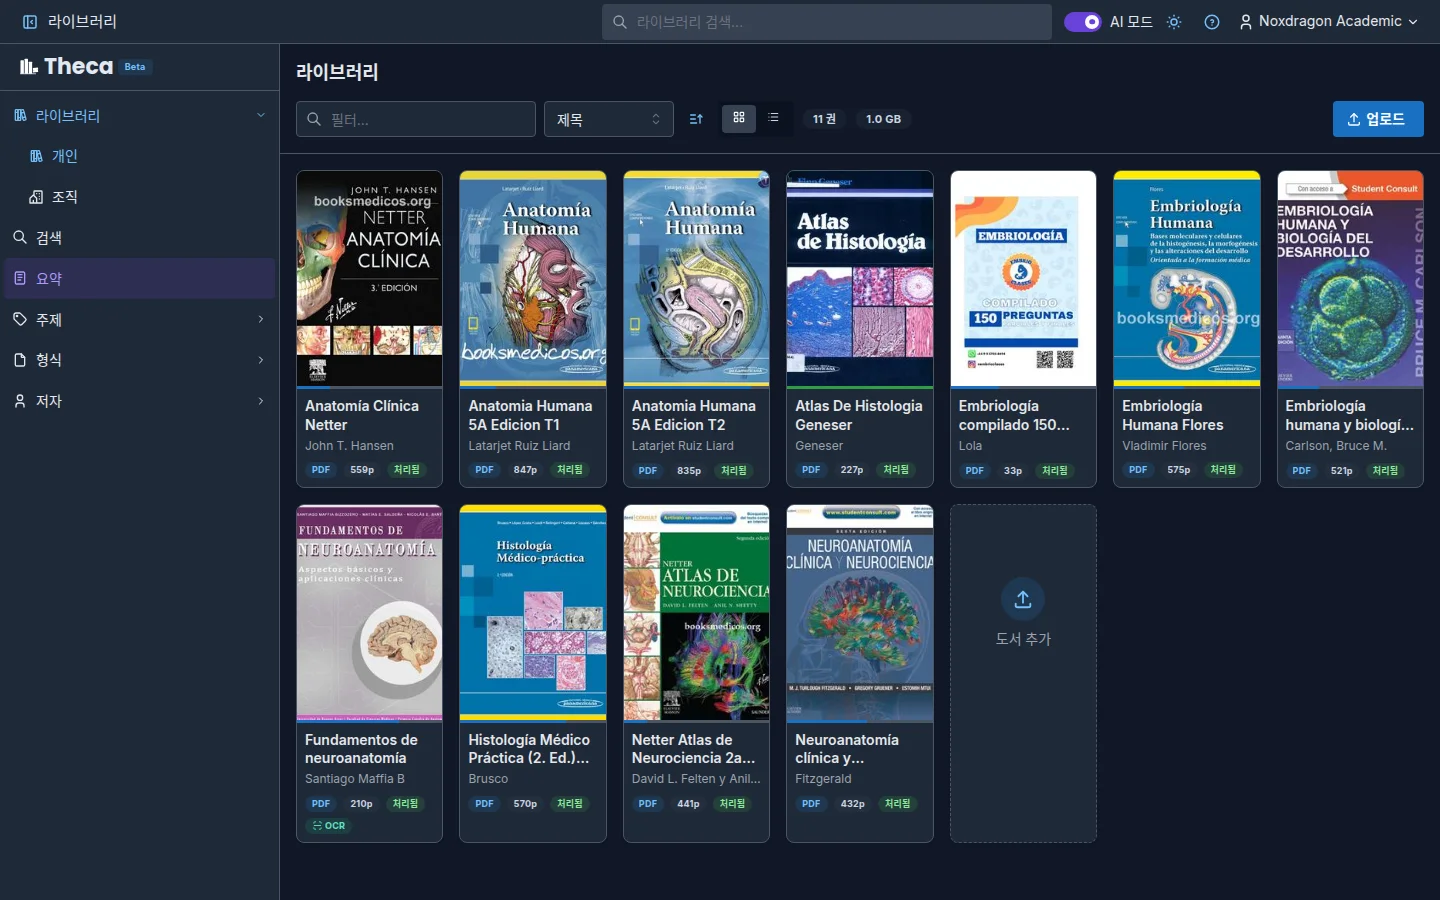
- 처리됨 — 검색과 요약에 사용할 준비가 되었습니다.
- 미처리 — 아직 처리되지 않았습니다. 패널의 처리 또는 도구 모음의 전체 처리를 누르십시오.
- 스캔됨, 텍스트 없음 — 인덱싱할 텍스트를 찾지 못했습니다.
- 중단됨 — 처리가 너무 오래 진행되지 않았고 이 도서를 처리하는 작업도 없습니다.
- 오류 — 다시 시도 — 문제가 발생했습니다.
아직 검색할 수 없는 도서는 사이드바의 미처리에 모여 있습니다.
멈춘 도서에도 항상 방법이 있습니다
도서가 중단됨 또는 오류 — 다시 시도 상태라면 상세 패널을 여십시오.
- 다시 시도를 누르면 다시 대기열에 추가됩니다.
- 스캔 문제였을 경우를 대비해 중단된 도서에도 **텍스트 추출 (OCR)**이 표시됩니다.
오류가 반복되면 파일을 다운로드해 기기에서 제대로 열리는지 확인하십시오.
콘텐츠 배지
- OCR — 스캔 이미지에서 텍스트를 인식했습니다.
- 수식 — 인식된 수학 또는 화학 기호가 포함되어 있습니다. PDF 리더의 수식 및 화학 패널에서 렌더링된 표기를 볼 수 있습니다.
자주 묻는 질문
처리에는 얼마나 걸리나요? 일반적인 크기의 도서는 몇 분이면 됩니다. 매우 긴 도서나 OCR을 거치는 도서는 더 오래 걸립니다.
OCR을 직접 실행해야 하나요? 아니요. 스캔 PDF를 감지하면 Theca가 자동으로 적용합니다. 텍스트 추출 (OCR) 버튼은 다시 시도할 때 사용합니다.
처리 중인 도서를 읽을 수 있나요? 네, 언제든지 가능합니다.
읽기 전용 도서는 어떻게 되나요? 플랜의 저장 공간을 초과한 도서는 읽기, 다운로드, 삭제는 가능하지만 재처리는 불가능합니다. 플랜 및 한도를 참고하십시오.